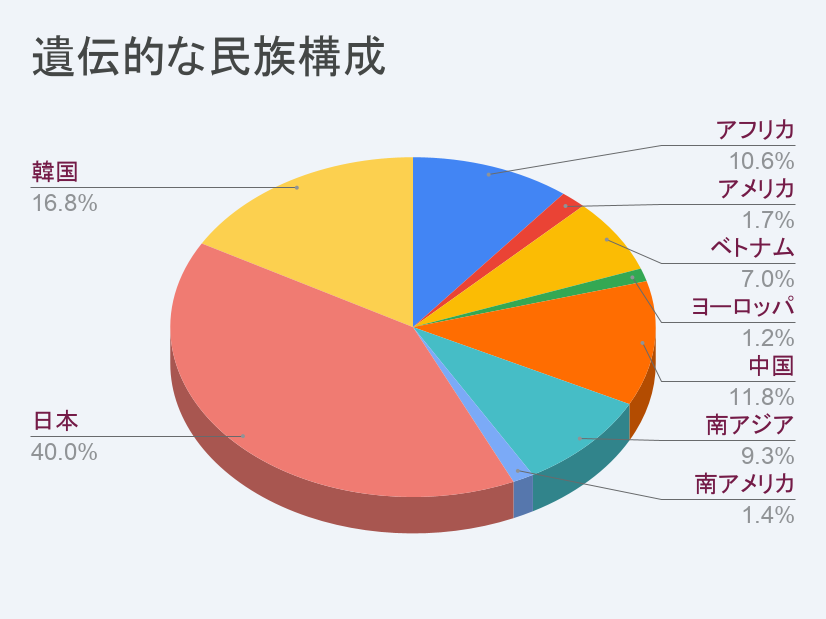
遺伝子検査サービスを提供するseeDNA遺伝医療研究所は、祖先の民族構成が分かる遺伝子検査「DNAルーツ」を開始し、日本在住者6,752人の口腔上皮サンプルをもとにした解析データを公表しました。700カ所のSNV(一塩基多型)を解析し、国際的な参照データ(1000人ゲノムプロジェクト)と照合したとしています。公表値の中でも注目を集めそうなのが、日本人特異的な遺伝的要素の平均が39.99%で、残り約6割が「日本人特異的ではない」要素に由来するという点です。さらに構成比では、韓国関連が16.81%、中国系が11.85%と続くとされます。前回発表分として「90%以上が日本人DNA」の人が1.91%にとどまる一方、「10%未満」も20.01%いるという“U字型分布”も提示され、単一の血統像を前提にした理解が揺さぶられます。
ただし、この手の「民族割合」は、国籍や文化的自己認識をそのまま測る指標ではありません。参照集団(比較先のデータ)の設計や、700SNVというマーカー数、推定アルゴリズムの前提によって割合は動き得ます。同じ人でも、検査会社や参照パネルが変われば数値が変わる可能性があるため、40%という数字は“境界線”というより“モデルに基づく近さの目安”として受け取るのが現実的です。それでも、近接する集団(韓国・中国など)との連続性が数値として可視化される点は、歴史人口学で語られてきた渡来と混交の蓄積を、消費者向けサービスに落とし込む動きとして位置づけられます。
数字が示す「近さ」
今回の発表は「純粋」という言葉が持つ誤解も浮かび上がらせます。公表データでは日本人特異的要素が高い人が少数派として示され、むしろ多様な組成が多数派として描かれます。これは優劣や真正性の話ではなく、ゲノムが連続体であるという性質を再確認させる材料になりそうです。
市場と社会の接点
背景には、個人向け遺伝子検査の一般化があります。一方で、結果の受け止め方を誤ると、出自や属性への短絡的なラベリングに繋がりかねません。公的統計では、2025年の出入国の規模が大きいことも示されており、移動が常態化する社会では「単一性」を前提にした物語が現実から離れやすくなります。遺伝子検査は自己理解の一助になり得る一方、解釈には参照データの限界や不確実性を織り込む姿勢が求められます。